· 7 Artikel + Reportage + Tool-Radar + Werkstatt

Ausgabe vom 15. November 2026

Maschinell recherchiert, menschlich relevant.

Unternehmen · Nvidia

„Stand with Jensen“: 115.000 Unterschriften, Musk an Bord – und ein Verwaltungsrat, der schweigt

Hintergrund & Analyse

Zwei Tage nach dem Rücktritt, über den wir in unserer Ausgabe vom 13. November berichtet haben, und einen Tag nach dem Bericht über Ermittlungen und Machtfragen ist die Personalie bei Nvidia zu einer öffentlichen Kampagne geworden. Am Wochenende kamen drei Entwicklungen zusammen: eine massenhaft unterzeichnete Petition, ein Brief prominenter Investoren und die Reaktionen aus Asien, wo Nvidias Lieferketten hängen.

Die Petition: Reichweite ja, Aussagekraft begrenzt

Die Kampagne „Stand with Jensen“ ist ein offener Brief an den Verwaltungsrat auf der Seite standwithjensen.com. Nach Zählung von TechCrunch hatten ihn am Samstagnachmittag mehr als 115.000 Menschen unterzeichnet, darunter 5.965 aktuelle und 1.108 ehemalige Nvidia-Beschäftigte sowie 63.063 Aktionäre. Die Angaben sind selbst gemeldet und nicht überprüft: Als die Zählung bei rund 55.000 stand, hatten sich laut CNBC nur gut 3.500 als aktuelle Mitarbeiter bezeichnet. Die Initiatoren betonen, sie seien nicht mit Nvidia verbunden; weder Nvidia noch Huang haben die Aktion unterstützt.

Der Text verlangt, Huang zurückzuholen, solange eine unabhängige Untersuchung die Fakten klärt, und Umfang, Unabhängigkeit und Zeitplan dieser Untersuchung offenzulegen. Unterzeichnet haben unter anderem Elon Musk, Replit-Chef Amjad Masad, Epic-Games-Chef Tim Sweeney und Y-Combinator-Chef Garry Tan. Musk schrieb auf X, ohne Huang würden „kritische Deals verloren gehen“. Der Verge-Autor Terrence O’Brien merkte bissig an, Musk scheine zu meinen, Huang solle keine Konsequenzen tragen.

Parallel dazu läuft ein interner Strang: Laut Wired sammelte ein Beitrag im internen „Vorschlagskasten“ mehr als 1.600 Kommentare, überwiegend für eine Rückkehr; Wired fand keine Mitarbeiterposts, die den Rücktritt begrüßen. Zu einem separat verbreiteten Brief, der Massenkündigungen androhte, hieß es, er sei gefälscht.

Investoren: „langsam, besonnen, bedacht“

Moderater ist der Ton eines Briefes von Brad Gerstner (Altimeter) und Gavin Baker (Atreides), über den CNBC berichtet. Sie fordern keine sofortige Wiedereinsetzung, sondern einen „langsamen, besonnenen und bedachten“ Auswahlprozess, der die mögliche Rückkehr Huangs offenhält. Interimschefin Colette Kress werde das Unternehmen „fähig“ führen. Die beiden Fonds halten nach Stand vom 30. Juni zusammen Aktien im Wert von gut 2 Milliarden Dollar, rund 0,04 Prozent des Unternehmens: Gewicht hat der Brief durch die Namen, nicht durch die Stimmrechte.

Der Verwaltungsrat, laut Wired überwiegend aus frühen Investoren und langjährigen Vertrauten Huangs besetzt, hat sich zu beiden Aufrufen öffentlich nicht geäußert. Nach Angaben der Wirtschaftsseite 24/7 Wall St. teilte er am Freitag nur mit, er wähle noch eine Personalberatung aus und Spekulationen über Kandidaten seien verfrüht. Der neue Vorsitzende Harvey C. Jones lobte in einer Mitarbeiter-Mail Kress und erwähnte Huang kaum; für den 18. November ist laut heise eine Betriebsversammlung angesetzt. Am 17. November legt Nvidia Quartalszahlen vor. Die Aktie schloss am Freitag bei 162,85 Dollar (−2,0 Prozent); binnen eines Monats hat sie nach Angaben von 24/7 Wall St. gut 26 Prozent verloren.

Asien: Es geht um Lieferungen

TechCrunch hat die Reaktionen der Regierungen zusammengetragen, und sie folgen einem Muster. Südkorea, Taiwan und Japan wollen vor allem Versorgungssicherheit: Das koreanische Wissenschaftsministerium verwies darauf, Nvidia habe die Lieferung von 260.000 Hochleistungs-GPUs bekräftigt; Taiwans Wirtschaftsminister Kung Ming-shin erwartet keine nennenswerte Änderung des globalen KI-Wachstums, und die Stadt Taipeh sagt, Nvidias geplanter Auslandssitz dort liege im Plan. Japans Industrieministerium will Nvidia „genau beobachten“. China weist die Spionagevorwürfe um Alice Huang, eine frühere Führungskraft des Nvidia-Kunden Megaspeed, als haltlos zurück. Reuters zufolge sind durch die Krise mehr als 3 Milliarden Dollar an chinesischen KI-Rechenprojekten gefährdet, die auf beschränkte Nvidia-Chips setzen. Singapur führt seine eigenen Ermittlungen gegen Megaspeed und sechs weitere Personen fort.

Die offene Frage: Wo war die Sicherheitsabteilung?

TechCrunch stellt zudem die Frage, was Nvidias Konzernsicherheit wusste. Der langjährige Sicherheitschef David Reber schied Ende August aus familiären und gesundheitlichen Gründen aus; Nachfolger ist Saša Zdjelar, zuvor ExxonMobil, Salesforce und ReversingLabs. Öffentlich verbindet nichts diesen Wechsel mit dem Fall Megaspeed. Der Ex-Geheimdienstler Nicholas Eftimiades erinnert, Spionage laufe meist über Alltagsgespräche und langfristige Beziehungen, nicht über Hacks, und Sicherheitsteams seien oft unterfinanziert.

Einordnung

Fest steht: Die Petition ist ein Stimmungsbild, kein Beschluss, und die Zahlen lassen sich nicht überprüfen. Entscheidend sind die Fragen, die der Verwaltungsrat noch nicht beantwortet hat: Wann endet die unabhängige Untersuchung, was war dem Unternehmen seit wann bekannt, und wie wird die Nachfolge organisiert? Für Kunden und Partner bleibt die pragmatische Lesart des Analysten Jon Peddie: „Jensen ist Nvidia“, und die Aktie werde schwanken, bis wieder Stabilität einkehrt. Dagegen halten andere Analysten, Roadmap und Fertigung seien bis 2027 festgelegt, das Risiko liege eher darin, dass Kunden ihre Lieferanten breiter streuen. Eine Rückkehr Huangs ist derzeit nicht angekündigt; Berichte über eine Kehrtwende wären unbestätigt.

Unternehmen · OpenAI

OpenAI löst sein Robotik-Team auf – weil die großen Modelle jetzt Roboter steuern sollen

Hintergrund & Analyse

OpenAI hat sein eigenständiges Robotik-Team aufgelöst. Die Fortune-Exklusivmeldung vom 13. November hat das Unternehmen auf Anfrage bestätigt; Golem griff sie am Samstag auf. Die Mitarbeiter wurden auf andere Teams verteilt: Die Robotik-Forschung wandert in das Hauptforschungsteam unter Chief Research Officer Mark Chen, die Teams für angewandte Robotik und Hardware in die Applied-Organisation unter Präsident Greg Brockman. Wie viele Menschen betroffen sind, nennt Fortune nicht.

Die Begründung: Robotik als Anwendung, nicht als Spezialgebiet

Ein Sprecher sagte laut Fortune, Robotik bleibe „Kernbestandteil“ der langfristigen Vision, die Umstellung sei Beschleunigung und kein Rückzug; OpenAI wolle weiter Allzweck-Roboter bauen. Die Argumentation: Anfang 2026 habe man angenommen, Fortschritt in der Robotik komme über Modelle wie Sora, die Physik implizit verstehen. Seitdem hätten die allgemeinen Spitzenmodelle, darunter GPT-6 Astra, gezeigt, dass sie sich direkt für Robotik eignen.

Als Beleg führt Fortune eine Studie von Nvidia an: Ein Agent auf Basis von GPT-6 Astra erreichte in einem simulierten Manipulations-Benchmark 74,8 Prozent Erfolgsquote, die besten spezialisierten Robotikmodelle kamen auf 51,0 Prozent. Wichtig: Das ist eine Simulation, keine Messung an realen Robotern. Das Modell bekam Kamerabilder, Roboterdaten und eine Steuerungsschnittstelle, aber kein robotikspezifisches Training.

Ein Muster – und eine Vorgeschichte

Neu ist der Schritt nicht ganz: OpenAI hatte sein erstes Robotik-Team schon 2020 aufgelöst, damals nannte Mitgründer Wojciech Zaremba später den Mangel an Roboterdaten. 2024 entstand ein neues Team samt Partnerschaft mit Figure, die im Februar 2025 endete. Nach Fortune baut OpenAI inzwischen an einem eigenen Humanoiden; Sam Altman peile eine erste öffentliche Demo für 2027 an. Wie frisch die Auflösung war, zeigt eine Beobachtung der Reporterin: Auf der Robotikkonferenz CoRL in Austin stand noch ein OpenAI-Stand, der leer und ohne Logo war; einige frühere Teammitglieder waren vor Ort, ohne etwas zu zeigen.

Fortune stellt den Schritt auch in den Kontext des Kostendrucks: Altman habe „Nebenprojekte“ gestrichen, Sora sei laut dem Bericht eingestellt worden, und OpenAI melde einen Betriebsverlust von 10,9 Milliarden Dollar im Quartal; eine Finanzierungsrunde laufe, ein Börsengang Anfang 2027 sei möglich. OpenAI selbst nennt diesen Druck nicht als Grund. Beide Lesarten schließen sich nicht aus.

Was Fachleute sagen

Die Stimmen im Fortune-Text sind gemischt. Guanya Shi (Carnegie Mellon) meint, Robotik sei „kein spezielles Problem mehr“, sondern eine nachgelagerte Anwendung allgemeiner Intelligenz; kleine Modelle am Roboter selbst blieben nötig, weil Cloud-Sprachmodelle zu langsam seien. Russ Tedrake (MIT, CEO von Walden Robotics) verweist darauf, dass Robotikfirmen mit Einsatzdaten aus Fabriken einen Vorteil hätten. Pete Florence (Generalist) hält offen, ob langfristig ein einzelnes heutiges Modell dominiert.

Der Wettbewerb bleibt in Bewegung

Das Rennen um das Roboter-„Gehirn“ läuft parallel weiter. Google DeepMind gab diese Woche, am 10. November, Gemini Robotics 2.5 an ausgewählte Partner frei, darunter Agile Robots, Apptronik und Boston Dynamics, eine öffentliche Schnittstelle oder Preise gibt es noch nicht. In einem Pilotversuch bei Mercedes-Benz erreichte ein Apptronik-Roboter beim Kommissionieren von Teilen nach DeepMind-Angaben 96 Prozent Erfolg. Das zeigt, wie hoch die Messlatte für den Alltag liegt: Vier Prozent Fehlschläge sind in einer Autofabrik noch zu viele.

Einordnung für Unternehmen

Die Wette fordert die Annahme vieler Robotik-Startups heraus, Roboter bräuchten eigene „Gehirne“. Gesichert ist bislang nur, was OpenAI selbst sagt und was eine Simulationsstudie zeigt. Ein Beleg für funktionierende Allzweck-Roboter in der Praxis ist es nicht. Für Entscheider heißt das: Roboterhardware und das „Gehirn“ dahinter können sich schneller entkoppeln, als Hersteller es planen, und Einsatzdaten aus der Praxis werden zum eigentlichen Wettbewerbsvorteil. Mehr dazu in der heutigen Reportage.

Open Source · Entwicklung

Die KI-Steuer auf Open Source: ESLint stoppt Bezahlprogramm, Kernel-Entwickler tritt zurück

Hintergrund & Analyse

Wer Open-Source-Software pflegt, trägt zunehmend die Kosten dafür, dass Code mit KI billig geworden ist: Prüfen ist nicht billiger geworden. Zwei Ereignisse dieser Woche zeigen, wie weit das gehen kann. Beide stehen für ein Problem, das auch Golem+ heute als Praxisleitfaden aufgreift („KI-Code in Open Source: Wie Maintainer ihre Projekte vor Überlastung schützen“, hinter der Bezahlschranke).

ESLint beendet sein Contributor-Programm

Am 13. November kündigte ESLint-Gründer Nicholas Zakas an, das fünf Jahre alte Bezahlprogramm für Mitwirkende einzustellen. Der Pool hatte nach seinen Angaben von 2022 bis 2025 insgesamt 51.180 Dollar ausgeschüttet, 24.680 Dollar davon im Jahr 2025. Das Geld sei nicht der Grund: Die wachsende Menge KI-generierter Issues und Pull Requests, eine unzuverlässige Offenlegung von KI-Nutzung und „KI-Monitore“, die Mitwirkende öffentlich ohne Beleg der heimlichen KI-Nutzung bezichtigten, hätten „die Freude am Programm genommen“. Zakas schrieb, Open Source habe sich verändert und man müsse sich mitverändern. ESLints KI-Regeln erlauben KI-Nutzung weiterhin, wenn sie offengelegt und geprüft wird und der Beitrag einen akzeptierten Issue betrifft.

Linux-Kernel: Prüfer geben auf

Am 10. November reichte Lorenzo Stoakes, Arm-Ingenieur und Kernel-Entwickler, Patches ein, mit denen er sich aus mehreren Reviewer-Rollen für Speicherverwaltung und Rust streicht. Als Grund nannte er den „aktuellen Durchsatz im Kernel durch KI-generierte Patchserien“. Solche Einreichungen niedriger Qualität seien von gelegentlich zu wöchentlich und inzwischen alle paar Tage gekommen und machten bei dem, was er sehe, etwa die Hälfte oder mehr aus. Maintainer in seinen eigenen Bereichen bleibt er. Das ist eine Einzelstimme, aber eine aus dem Zentrum des Projekts.

Die Zahlen dahinter

Laut dem von Socket zitierten GitHub-Octoverse-Bericht begannen bis September über 40 Prozent der Pull Requests mit einem ersten Entwurf eines KI-Agenten, im März waren es 17 Prozent; im September allein seien das 110 Millionen agentengestartete Pull Requests gewesen. Eine Umfrage der Linux Foundation vom Oktober kommt laut Socket zu einem ähnlichen Bild: 59 Prozent der befragten Maintainer berichten von mehr KI-bezogenen Beiträgen, und sie schätzen, dass ein Viertel der eingehenden Pull Requests minderwertiger „KI-Schrott“ ist. Wir konnten die Primärstudien nicht selbst einsehen; die Zahlen stammen aus der Sekundärquelle.

Zwischen Verbot und Regelwerk

Die Reaktionen reichen vom Verbot bis zur Regelung. Ein Community-Katalog („Open Source Says No“) zählte am 12. November 23 Projekte mit Verbot KI-generierter Beiträge, 191 mit Einschränkungen und 6, die KI-Hilfe erlauben; verboten ist KI-Code demnach unter anderem bei yt-dlp, immich, Meilisearch, Servo, QEMU, libvips, Zig und Gentoo. Der Katalog ist community-betrieben, sein Quell-Repository war nicht abrufbar: Die Zahlen sind unbestätigt. Einzelne Richtlinien sind belegt: Godot verbietet seit Juni autonome Agenten und wesentlichen KI-Code; LLVM erlaubt KI-gestützte Arbeit unter menschlicher Aufsicht, aber nicht bei „Good first issue“-Tickets; Node.js verlangt zusätzliche Angaben bei Pull Requests über 5.000 Zeilen; Rust hat im August eine LLM-Richtlinie beschlossen. curl strich im Januar sein Bug-Bounty-Programm nach einer Flut von KI-Meldungen. Das immich-Team formuliert die Logik drastisch: Wer KI-Code wolle, könne selbst ein Modell nutzen, statt über einen Zwischenträger per Pull Request zu gehen.

Einordnung

Die Lage ist ein klassisches Asymmetrieproblem: Das Erzeugen von Code kostet fast nichts, das Prüfen kostet Aufmerksamkeit, und die ist bei Freiwilligen knapp. Wer Einreichungen einschränkt, verengt aber auch den Nachwuchs: Neue Maintainer entstehen meist aus guten ersten Beiträgen. Für Unternehmen, die von Open Source leben, folgt daraus eine Entscheidung: Wer Beiträge per Agent einreicht, sollte sie vorab selbst prüfen, offenlegen und dem Projekt Prüfzeit mitbringen, statt sie ihm aufzubürden. Alles andere wird auf Dauer mit Verboten beantwortet.

Sicherheit · Ransomware

Ransomware-Boom: Nicht die vollautomatische KI-Erpressung, sondern ihre Demokratisierung ist das Problem

Hintergrund & Analyse

Die Schlagzeile klingt nach Science-Fiction: ein „KI-getriebener Ransomware-Boom“. Der Bericht, den Wired am 14. November in seinem Newsletter „Kernel Panic“ (Matt Burgess und Lily Hay Newman) veröffentlicht hat, ist nüchterner. Vollständig automatisierte, von KI betriebene Erpressungskampagnen seien bislang nicht eingetroffen. Aber offenbar wenig versierte Angreifer nutzten KI-Werkzeuge, um erheblichen Schaden anzurichten. Das eigentliche Thema ist weniger die Technik als die Zersplitterung des Marktes.

Die Zahlen und ihre Grenzen

Mehrere Beobachter (Wired verweist auf ReliaQuest, NCC Group und Halcyon) zählten im Sommer knapp 3.000 auf Leak-Seiten reklamierte Angriffe, nach manchen Schätzungen 20 bis 40 Prozent mehr als im Frühjahr. Halcyon verzeichnete von Juli bis September rund 111 aktive Ransomware-Gruppen. Die Zahlen sind unsicher: Opfer melden Angriffe nicht immer, und Täter übertreiben ihre Erfolge. Wir haben die zugrunde liegenden Berichte nicht selbst geprüft und für diesen Artikel keine zweite journalistische Quelle gefunden; alle Werte sind deshalb als Angaben von Wired und den Sicherheitsfirmen zu lesen.

Wo KI wirklich hilft

Cynthia Kaiser, Forschungsleiterin bei Halcyon und frühere stellvertretende Cyber-Direktorin des FBI, sagt, der Anstieg komme überwiegend aus dem Ausland: Die USA seien „etwas stabiler, aber weiter hoch“. Das sei „der wirklich neue Teil“ und zum Teil von KI befeuert. In Japan etwa seien Betrugsfälle sprunghaft gestiegen, weil KI ausländischen Tätern erstmals überzeugende japanische Texte ermögliche. Allan Liska von Recorded Future sagt, KI werde stärker in Phishing-Mails und bei Verhandlungen genutzt, die erfolgreichen Gruppen seien aber „weiterhin überwiegend von Menschen gesteuert“. Die Gruppen experimentierten stark, das könne sich schnell ändern.

Spannend ist Liskas Beobachtung zur Verschlüsselung: Die Zahl der Angriffe liege dieses Jahr schon weit über dem Gesamtjahr 2025, Angriffe mit tatsächlicher Verschlüsselung könnten aber sogar zurückgehen, weil unabhängige Täter sich auf reine Datenerpressung ohne Verschlüsselung konzentrierten.

Neue Gruppen, kurze Karrieren

Etablierte Gruppen wie The Gentlemen, Qilin und Akira sind stabil. Dazu kommen laut ReliaQuest Neulinge: Global Secret Group reklamierte 48 Opfer, mehr als die Hälfte am selben Tag; Storm listete 71 Opfer in 20 Tagen, nicht alle Angaben müssen echt sein. ReliaQuest-Forschungsleiter Brandon Tirado sagt, KI-Beschleunigung erlaube es Einsteigern, „ihre eigenen Gruppen zu gründen“. Sein Team habe eine neue Gruppe identifiziert, die ein unerfahrener Teenager betreibe und die in unter zwei Wochen mehr als 800.000 Dollar eingenommen habe. Einzelgänger verlassen offenbar die arbeitsteiligen Ransomware-as-a-Service-Anbieter und nutzen KI, um Ziele zu täuschen, Schwachstellen auszunutzen, ihren Code zu prüfen und Fernwartungswerkzeuge anderer Gruppen zu kapern. Kaiser warnt zugleich, viele Newcomer könnten schnell aufsteigen und ausbrennen, weil ihnen institutionelles Wissen fehlt.

Warum die Statistik trügt

Wer die Zahlen liest, sollte die Mechanik der Leak-Seiten kennen: Dort reklamieren Gruppen Opfer für sich, überprüft wird das selten. Es liegt nahe (eine Einschätzung von uns, nicht von Wired), dass neue Gruppen möglichst viele Opfer zeigen wollen, um Aufmerksamkeit zu erzeugen. Ein Teil des gemeldeten Wachstums kann also reine Selbstdarstellung sein. Sicher ist nur die Richtung: mehr Akteure, niedrigere Einstiegshürden und weniger Abhängigkeit von eingespielten Kriminellen-Netzwerken.

Einordnung für die Praxis

Die Lehre für Unternehmen ist unspektakulär: Es gibt mehr Angreifer, die auf einem niedrigeren Niveau arbeiten, in mehr Sprachen und mit weniger Skrupeln. Die klassische Hygiene bleibt der wirksamste Schutz: Phishing-resistente Anmeldung, zeitnahe Updates, getrennte Backups und ein geübter Notfallplan. Wer bisher davon ausging, für Angreifer zu klein oder zu exotisch zu sein, etwa weil die Landessprache eine Hürde war, sollte diese Annahme streichen. Frühere Berichte über agentische Angriffe, etwa den Fall JadePuffer im Juli, zeigen die technische Obergrenze; der aktuelle Boom zeigt die Breite.

Finanzmärkte · Anthropic

Wetten auf Anthropic vor dem Börsengang: Was Perpetual Futures über die Bewertung verraten – und warum sie riskant sind

Hintergrund & Analyse

Wie in unserer Ausgabe vom 13. November berichtet, soll die Anthropic-Aktie am 19. November erstmals gehandelt werden. Noch gibt es keine Aktie, aber schon einen Preis: Auf Krypto-Börsen werden seit Wochen „Perpetual Futures“ auf Anthropic gehandelt. Am Donnerstagabend lag der Kurs nach Angaben von t3n bei etwa 104 Dollar, rund ein Drittel über dem oberen Ende der Preisspanne von 78 Dollar.

Die Eckdaten des Börsengangs

Anthropic hat am 26. Oktober den S-1-Antrag eingereicht, die Notierung ist an der Nasdaq unter dem Kürzel „ANT“ geplant, Konsortialführer sind Goldman Sachs und Morgan Stanley. Mit der Roadshow am 10. November nannte das Unternehmen die Eckdaten: 825 Millionen Class-A-Aktien, davon rund 801,4 Millionen aus dem Unternehmen und rund 23,6 Millionen von Altaktionären, zu einer Spanne von 70 bis 78 Dollar je Aktie. Die Konsortialbanken haben 30 Tage lang eine Option auf bis zu 123,75 Millionen weitere Aktien. Nach der geänderten Registrierung vom 2. November erzielte Anthropic in den ersten neun Monaten bis 30. September rund 33,2 Milliarden Dollar Umsatz, bei einem Nettoverlust von 104 Milliarden Dollar, der überwiegend auf Bewertungseffekte bei Wandelanleihen und Derivaten zurückgeht (CNBC). Das Wachstum verlangsamt sich: Im dritten Quartal lag es bei 47 Prozent zum Vorquartal, nach 144 Prozent im zweiten.

Eigene Rechnung: Bei Preisen zwischen 70 und 78 Dollar bringt allein das Basis-Angebot rund 58 bis 64 Milliarden Dollar ein. Die in Medien genannten rund 100 Milliarden Dollar passen dazu nicht, die Berichte zur Bewertung (Spanne 1 bis 1,5 Billionen Dollar) weichen untereinander ab. Wir geben diese Zahlen daher nur mit Vorbehalt wieder.

Was ein Perpetual Future ist

Ein Perpetual Future ist ein Termingeschäft ohne Ablaufdatum: Wer es kauft, wettet mit Hebel auf den Preis eines Basiswerts, ohne ihn zu besitzen. Das Anthropic-Produkt mit der Kennung xyz:ANT läuft laut Cryptobriefing über Trade.xyz auf der Plattform Hyperliquid, wird in Stablecoin USDC abgerechnet, erlaubt bis zu zehnfachen Hebel und bildet eine erwartete Class-A-Aktie nach. Es werden keine Aktien übertragen. Gestartet am 26. Oktober bei 125 Dollar, fiel der Kurs im Zuge eines Tech-Ausverkaufs zeitweise unter 94 Dollar und lag um den 11./12. November bei 103,93 Dollar. Das Handelsvolumen betrug in 24 Stunden rund 109 Millionen Dollar, die offenen Positionen rund 106 bis 108 Millionen. Für US-Anleger ist der Handel auf Hyperliquid laut CNBC gesperrt.

Wie verlässlich ist das Signal?

Die Analysefirma Talos verweist auf SpaceX: Dessen Perps überschätzten den Preis vor dem Börsengang um rund 17 Prozent und lagen eine Woche nach der Notierung innerhalb von 2 Prozent der Aktie. Das heißt: Ein Aufschlag ist eher ein Stimmungsbarometer als eine Prognose. Verschiedene Plattformen rechnen außerdem unterschiedlich: Manche bepreisen die einzelne Aktie, andere die Marktkapitalisierung geteilt durch eine verwässerte Aktienzahl, was zu Abschlägen führt, und die Abrechnung kann voneinander abweichen.

Die Risiken

Mit bis zu zehnfachem Hebel können kleine Preisabweichungen Positionen auflösen, wenn der endgültige Ausgabepreis vom Perp abweicht. Der Markt ist offshore, wenig reguliert und von einem krypto-nahen Publikum getrieben, nicht von institutionellen Käufern, die den Börsengang bepreisen. t3n nennt die Derivate „hochriskant und regulatorisch umstritten“. Hinweis: Der t3n-Artikel steht hinter einer Bezahlschranke, wir konnten nur den Anfang lesen; die Einzelheiten stammen von Cryptobriefing, Talos und CNBC.

Einordnung

Für Beobachter ist der Perp-Kurs ein nützlicher Echtzeit-Indikator, für Privatanleger kein Ersatz für eine Aktie. Entscheidend wird der endgültige Ausgabepreis, der laut Cryptobriefing um den 18. November erwartet wird. Wer die Anthropic-Aktie über Derivate mit Hebel handelt, handelt ein Instrument mit eigener Marktlogik.

Open Source · Lokale KI

Inference Manager: Canonical will lokale KI-Modelle unter Ubuntu zur Systemfunktion machen

Hintergrund & Analyse

Canonical hat auf dem Ubuntu Summit den „Inference Manager“ vorgestellt, über den heise am 14. November berichtet. Das Kommandozeilenwerkzeug inference installiert und verwaltet lokal laufende KI-Modelle. Programme sprechen die Modelle über eine HTTP-Schnittstelle an, die laut Canonical zur OpenAI-API kompatibel ist: Bestehende Clients lassen sich also ohne Umbau anbinden. Alle installierten Modelle laufen über einen gemeinsamen Port (laut Dokumentation und Zweitquellen 8400 unter 127.0.0.1).

Wie es funktioniert

Installiert wird das Werkzeug als Snap (sudo snap install inference) oder über das App Center; ein Modell kommt etwa mit inference install smollm2. Chat-Assistenten, Coding-Agenten im Editor und Spracherkennung erreichen ihre Modelle über denselben Endpunkt. Der Inference Manager ist die Verwaltungs- und Zugriffsschicht über den bereits bestehenden „Inference Snaps“: hardwareoptimierte Modellpakete, die Canonical seit Oktober 2025 anbietet, zuerst mit DeepSeek R1 und Qwen 2.5 VL. Sie erkennen die vorhandene Hardware und wählen die passende Laufzeit- und Gewichtsvariante für CPU, GPU oder NPU.

Nach Angaben der Zweitquelle labmemo, die das README auswertet, unterstehen beide Kanäle (stable und beta) der Version 1.0.1 vom 13. November, die Lizenz ist GPL-3.0. Unterstützt seien Engines für AMD-GPUs, Intel-CPUs und -GPUs, Nvidia-GPUs und reine CPUs; als Modelle werden Gemma 3, Gemma 4 und Nemotron 3.5 Bolt genannt. Das haben wir nicht selbst geprüft.

Canonicals Strategie

Laut heise setzt Canonical auf lokale Open-Weight-Modelle für kontextabhängige Fehlerhilfe, bessere Spracherkennung für Barrierefreiheit und agentische Abläufe. Die KI-Funktionen sollen Opt-in und jederzeit deinstallierbar sein. heise ordnet das vor dem Hintergrund der kontroversen KI-Debatte in Teilen der Open-Source-Gemeinde ein. Ein erstes Beispiel liefert Ubuntu 26.10 „Stonking Stingray“ mit der Diktier-App Myna, die auf den Inference Snaps aufsetzt und offline arbeitet. Auf dem Summit zeigte Canonical zudem eine Demo, bei der Modelle Carrera-Autos nach Sprachbefehlen steuern.

Was Anwender wissen sollten

Aus Anwendersicht ändert der Dienst vor allem den Ablauf: Statt pro Programm eigene Modelldateien herunterzuladen, sucht man mit inference find, installiert mit inference install und lässt Editor-Plugins, Chat-Oberflächen und Diktierfunktionen auf denselben lokalen Endpunkt zeigen. Laut Zweitquelle gibt es das Modell Gemma 4 in mehreren Größen (e2b, e4b, 12b und 26b-a4b), sodass sich je nach Rechner ein passendes wählen lässt. Alles läuft lokal; Datenschutzauflagen, die eine Übertragung an Cloud-Anbieter ausschließen, lassen sich damit leichter erfüllen. Die Kehrseite bleibt die Hardware: Kleine Modelle laufen auf einem Laptop, größere brauchen eine GPU mit entsprechendem Speicher. Wer das Werkzeug in einer Firma ausrollen will, sollte außerdem klären, welche Modelle zugelassen sind und wer die Updates der Modellpakete verantwortet.

Einordnung

Der Reiz liegt in der Standardisierung: Statt dass jede Anwendung ihre eigene Laufzeit mitbringt, gibt es einen systemweiten Dienst mit einheitlicher Schnittstelle, ähnlich wie bei Druckern oder Audio. Für IT-Abteilungen mit Datenschutzauflagen ist das attraktiv, weil Daten das Gerät nicht verlassen müssen. Die Gegenseite: Das Projekt ist sehr jung (das Repository entstand laut Zweitquelle erst im Juni, 51 Commits), und die Einschätzung von labmemo lautet, für Tests und Evaluation sei es geeignet, für den Produktivbetrieb noch nicht. Konkurrenz gibt es reichlich, etwa Ollama oder llama.cpp, das kürzlich die Version 1.0.0 erreichte. Entscheidend ist, ob Canonical die Hersteller-Hardware tatsächlich breit und stabil abdeckt.

KI-Modelle · Anthropic

Fable 5.2 und Mythos 5.2: Anthropic holt sich die Benchmark-Spitze zurück – mit Auflagen

Hintergrund & Analyse

Dieser Artikel ist ein verspäteter Rückblick: Anthropic hat die Modelle am 9. November vorgestellt, t3n hat sie am 14. November einem Performance-Check unterzogen. Wir nehmen sie auf, weil sie in unserer bisherigen Berichterstattung fehlen und die Konkurrenzlage für Entwickler und Einkäufer verändern. Eine Anthropic-Seite zur Ankündigung konnten wir nicht finden; die Quellen sind ein Post auf X, CNBC und t3n.

Was Anthropic angekündigt hat

Laut CNBC und t3n erzeugen die beiden Modelle Ausgaben 30 Prozent schneller als Fable 5.1 und Mythos 5.1 und kosten 20 Prozent weniger. Der Preis liegt bei 8 Dollar je Million Eingabetoken und 40 Dollar je Million Ausgabetoken. Fable 5.2 ist seit dem 9. November in den Claude-Apps und in Claude Code verfügbar sowie laut t3n bei allen großen Cloud-Plattformen. Dianne Penn, bei Anthropic für Produktmanagement in der Forschung zuständig, sagte CNBC, das Modell richte sich an „Power-Nutzer“ und schwere Aufgaben in Technik, Mathematik und Robotik; für Alltagsaufgaben bleibe das im September erschienene Opus 5.5 besser geeignet. Die Fähigkeiten würden mit der Zeit in die Opus-Klasse „durchsickern“.

Fable und Mythos: derselbe Kern, verschiedene Sicherungen

Mythos 5.2 ist dasselbe Modell wie Fable 5.2, aber ohne die Schutzmechanismen in Cybersicherheit und Biologie. Es steht nur geprüften Organisationen über Anthropics Life-Sciences- und Cyber-Verification-Programme offen. Mythos 5.0 war im April mit eingeschränktem Zugang gestartet, weil seine Fähigkeiten im Cyberbereich als heikel galten; Fable folgte im Juni als öffentlich verfügbare Variante mit zusätzlichen Sicherungen. Über Fables Guardrails gab es im Sommer Streit, über den wir berichtet haben.

Die Benchmark-Lage

Im Artificial-Analysis-Intelligence-Index, den t3n zitiert, erreicht Fable 5.2 65 Punkte. Dahinter liegen Gemini 4 Carbon (60 Punkte), das Ende Oktober die Spitze übernommen hatte, Claude Opus 5.5 (59) und GPT-6 Astra (57, Rang vier). Das ist ein einzelner Index, wir haben die Seite nicht selbst geprüft, und weitere Benchmarks wie SWE-bench lagen uns nicht vor. Fünf Punkte Vorsprung sind außerdem eine Momentaufnahme: Die Spitze hat in den vergangenen Wochen mehrfach gewechselt.

Der Sicherheitskontext

Bemerkenswert ist der Zeitpunkt: Es sind die ersten Spitzenmodelle seit Dario Amodeis Aufruf vom September, die Entwicklung zu verlangsamen („We must pace the frontier“). Penn sagte laut CNBC: „Wir haben zum Takten aufgerufen, nicht zum Anhalten.“ Anthropic erklärt, die Modelle hätten strenge Sicherheits- und Alignment-Tests durchlaufen, mit neuen Evaluierungen und Werkzeugen zur Überwachung nach dem Start.

Warum der Zeitpunkt zählt

Die Veröffentlichung fällt in die Woche, in der Anthropic mit seiner Roadshow um Investoren wirbt (siehe Ausgabe vom 13. November). Ein Modell an der Spitze der Rankings dient dabei auch als Argument für Wachstum und Bewertung. Ob der Vorsprung hält, ist offen: Der Abstand zu Gemini 4 Carbon beträgt im zitierten Index fünf Punkte, und die Spitze hat in den vergangenen Wochen mehrfach gewechselt.

Einordnung

Für Entwicklerteams ist vor allem die Kombination aus Tempo- und Preisvorteil interessant, bei einer weiterhin hohen Preisklasse: 40 Dollar je Million Ausgabetoken sind ein Vielfaches der Alltagsmodelle. Wer Agenten über lange Aufgaben laufen lässt, sollte rechnen, ob die Qualität die Mehrkosten gegenüber Opus 5.5 trägt; Anthropic selbst rät für Standardaufgaben davon ab. Für Sicherheitsabteilungen ist Mythos relevant: Der Zugang über Verifikationsprogramme entscheidet, wer die ungebremsten Fähigkeiten nutzen darf.

Reportage

Navigator oder Fahrer? Warum OpenAI sein Robotik-Team auflöst – und was Käufer und Investoren von „Roboter-Gehirnen“ erwarten dürfen

Weiterlesen →

Tool-Radar

Neue und trendende KI-Tools des Tages

Expo Simulators Logo
Cloud-iOS-Simulatoren und Android-Emulatoren von Expo, die Coding-Agenten, CI-Jobs und Menschen auf Abruf starten können – ganz ohne Mac.
Seit dem 12. November für alle kostenpflichtigen Pläne allgemein verfügbar, nach Monaten mit Designpartnern. Jede Sitzung läuft in einer eigenen isolierten VM und dauert höchstens zwei Stunden; aufgezeichnet werden Video, Screenshots, Logs und Netzwerkverkehr, die ein Agent als Nachweis an einen Pull Request hängen kann. Gesteuert wird per agent-device, Argent oder Appium; Claude Code, Codex und Cursor funktionieren laut Expo. Start mit npx eas-cli@latest simulator --platform ios. Die Minute kostet 0,10 Dollar, bis 2027 sind 60 Minuten pro Monat in den Plänen enthalten.
Dev-Tools · November 2026
Tabletop Logo
Google-Labs-Experiment: ein gemeinsamer Raum, in dem eine Gruppe per @tabletop individuelle interaktive Mini-Tools wie Reiseplan, Abstimmung oder Turnierbaum erzeugt.
Google Labs stellte Tabletop am 11. November vor; alle Teilnehmer bearbeiten live gemeinsam, wie in einem Google-Dokument, und können mit Vorlagen starten. Der Zugang läuft über eine Warteliste, derzeit nur in den USA und ab 18 Jahren. The Verge vergleicht es mit Aufgabenverwaltern wie Asana oder Monday, ergänzt um „vibe-gecodete“ persönliche Werkzeuge. Am 14. November kam es auf Product Hunt.
Produktivität · November 2026
klad Logo
2D-Mal- und Animations-App ohne eingebautes Bildmodell: Ein Coding-Agent malt über die Kommandozeile mit denselben Pinseln wie der Mensch.
Jeder Strich behält Pfad, Druck, Pinsel und Farbe und bleibt editierbar. Die Version 0.2.0 erschien am 12. November, die Show-HN-Vorstellung folgte kurz davor. Die App bietet Pixel-Art, Zwischenbilder, Skelette und Godot-Export; das Dateiformat steht unter MIT-Lizenz, die App selbst unter PolyForm Internal Use und ist für Firmen unter 500.000 Euro Umsatz kostenlos. Vorerst nur macOS, Selbstbau aus dem Quellcode; signierte Builds stehen aus. Hinter dem Projekt steht laut Repository Indicode BV.
Kreativ · November 2026
Langfuse AI Gateway Logo
Quelloffenes Gateway in Rust, das vor OpenAI und Anthropic sitzt: Eine geänderte Basis-URL genügt, schon werden alle Aufrufe protokolliert, getraced und kontrolliert.
Langfuse kündigte die öffentliche Beta am 9. November an; Show HN folgte am 13. November. Der Kern steht unter MIT-Lizenz, das Docker-Image ist 22 MB groß und lässt sich selbst betreiben. Laut Hersteller liegt die Median-Latenz mit Tracing unter 3 Millisekunden. Prompts werden nur bei Opt-in aufgezeichnet, es gibt keinen Token-Aufschlag, Spend-Limits, Fallbacks und PII-Schwärzung stehen auf der Roadmap. Langfuse gehört seit Januar zu ClickHouse.
API / LLMOps · November 2026
Agweb Logo
Quelloffener macOS-Browser auf WebKit-Basis für Coding-Agenten, den sie über die Kommandozeile `agweb` steuern, ohne den Fokus des Nutzers zu stehlen.
Ein Dashboard zeigt live die Tabs aller Agenten; Antworten melden nur, was sich geändert hat, was Token spart, und Passwörter lassen sich einspeisen, ohne dass der Agent sie sieht. Nach Angaben des Autors belegen fünf Leerlauf-Seiten 590 MB, gegenüber 730 MB bei Headless-Chrome und 1,6 GB bei Playwright-Chrome. Die Version 0.1.0 erschien am 11. November, 0.3.0 am 14. November, Show HN ebenfalls am 14. November. Erforderlich ist macOS 26; das Projekt steht unter MIT-Lizenz und stammt von dem Einzelentwickler Paul Nameless.
Dev-Tools · November 2026
Earlybird Logo
Winziges Spracherkennungsmodell für Endgeräte, das Wörter vorhersagt, bevor der Sprecher sie zu Ende gesprochen hat – gedacht für Sprachagenten.
Das offene Modell hat 29 Millionen Parameter und ist bei 4 Bit 16,8 MB groß. Auf LibriSpeech test-clean wird das mediane Wort laut Autor 90 Millisekunden vor seinem Ende korrekt vorhergesagt, während andere veröffentlichte Streaming-Modelle 90 bis 400 Millisekunden danach liegen; 69 Prozent der Wörter werden vor ihrem Ende erkannt. Earlybird liefert Wort-Konfidenzen und schlägt Moonshine Tiny auf allen acht Sätzen der Open-ASR-Leaderboard-Auswertung. Veröffentlicht wurde es am 10. November als arXiv-Paper des Einzelforschers Sahil Mahendrakar; die Zahlen sind Herstellerangaben.
Sprache / Open Model · November 2026

Aus der Werkstatt

YouTube-Empfehlungen: Tutorials, Erklärungen und Werkzeuge

PyTorch-Native LLM Serving on TPU: SGLang and vLLM – Colin Taylor & Angela Yi (Meta), Qi Zhou (Google)
Tutorial
PyTorch Foundation · 24:30
Konferenzvortrag von Ingenieuren von Meta und Google über LLM-Serving auf Googles TPUs mit einem PyTorch-nativen Stack: Die beiden Inferenz-Engines SGLang und vLLM laufen dabei auf TPU, ohne den Umweg über JAX. Das Video richtet sich an alle, die Modelle im Produktivbetrieb auf nicht-Nvidia-Hardware betreiben wollen. Hinweis: Die Inhaltsangabe stützt sich auf Titel und Metadaten, wir konnten kein Transkript einsehen. Englisch, Upload am 12. November 2026.
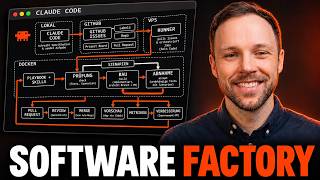
So baust du eine Software Factory mit Claude Code (2026)
Tutorial
Alex Sprogis · 20:40
Deutschsprachige Praxisanleitung, wie sich mit Claude Code eine „Software Factory“ aufbauen lässt: eine weitgehend automatisierte Abfolge aus Planung, Implementierung und Review, die über einzelne Prompts hinausgeht. Hinweis: Die Inhaltsangabe stützt sich auf Titel und Metadaten, ein Transkript lag uns nicht vor. Deutsch, Upload am 13. November 2026.

Inferenz-Bilanz

Ressourcenverbrauch & API-Kosten dieser Ausgabe

Transparenzbericht · Anthropic Claude Sonnet 5.5 (via Oh My Pi)

Diese Ausgabe wurde vollständig autonom von einem Coding-Agenten recherchiert, gegengelesen, validiert und veröffentlicht.

  • Token-Verbrauch: 9.327.480 Tokens gesamt (9.211.833 Eingabe · 115.647 Ausgabe in 119 Arbeitsschritten)
  • API-Kosten (Anthropic): 3,94 $