· 7 Artikel + Reportage + Tool-Radar + Werkstatt

Ausgabe vom 14. November 2026

Maschinell recherchiert, menschlich relevant.

Unternehmen · Nvidia

Nach Huangs Rücktritt: Ermittlungen, Machtfragen und ein Loch in der Startup-Finanzierung

Hintergrund & Analyse

Einen Tag nach dem Rücktritt, über den wir in unserer Ausgabe vom 13. November berichtet haben (und zuvor in der Ausgabe vom 12. November als Bericht über eine vorbereitete Abberufung), ist die Affäre um Jensen Huang nicht beendet, sondern breiter geworden. Am Freitag haben sich drei Stränge herauskristallisiert: neue Details über Huangs letzte Stunden im Amt und sein Verhältnis zur Interimschefin, Ermittlungen der US-Justiz und – für die Branche am wichtigsten – die Frage, was Nvidias Führungskrise für die Finanzierung der KI-Startup-Szene bedeutet.

Was bestätigt ist

Gesichert sind die Eckdaten, die Nvidia selbst veröffentlicht hat. Huang ist nicht mehr CEO; Finanzchefin Colette Kress führt das Unternehmen kommissarisch, Harvey C. Jones ist erster Vorsitzender des Verwaltungsrats. Huang hat am 8. November in einem Brief an die Belegschaft, den Nvidia auch als Pressemitteilung veröffentlichte, eine Affäre eingeräumt: „Ich war meiner Frau untreu“, schrieb er, es gebe „keine Entschuldigung“. Er verwies dabei auf „die in Medienberichten geäußerten nationalen Sicherheitsbedenken“, ohne Alice Huang zu nennen. Der Verwaltungsrat hatte eine unabhängige Untersuchung eingeleitet. Außerdem hat Huang eine Aussage vor dem Kongress zugesagt, die vor Thanksgiving (26. November) stattfinden soll – nach Angaben des Ausschussvorsitzenden Brian Mast hinter verschlossenen Türen, aber protokolliert.

Was nur berichtet oder behauptet wird

Alles Weitere beruht auf Medienberichten und Regierungsquellen. Nach Berichten der New York Times halten US-Behörden Alice Huang, eine Führungskraft des Singapurer Nvidia-Kunden Megaspeed, für eine Agentin des chinesischen Staatssicherheitsministeriums; sie soll eine enge Beziehung zu Jensen Huang gehabt haben. Beide sind nicht verwandt, die Namensgleichheit ist Zufall. Peking weist den Spionagevorwurf zurück, wie heise berichtet. Nvidia erklärte Ende Oktober, Huangs Kontakte zu ihr seien „nicht ungewöhnlich“, und wies darauf hin, dass der Konzern von der US-Regierung informiert worden wäre, wenn sie eine Gefahr darstelle. Nach Berichten, die TechCrunch und die NYT wiedergeben, wurde auch Präsident Trump bereits im Herbst 2025 über die Überwachung informiert; belegt ist das nur durch die Berichterstattung, nicht durch eine offizielle Bestätigung. Die New York Times berichtet unter Berufung auf fünf frühere Nvidia-Beschäftigte zudem über eine Beziehung mit der Vizepräsidentin Kimberly Powell, die ihm direkt unterstellt war; Nvidia, Huang und Powell haben das nicht bestätigt. Reuters meldet unter Berufung auf zwei Personen eine weitere Beziehung mit einer nicht genannten Mitarbeiterin.

Die Justiz ermittelt – ohne Anklage in Sicht

Laut Semafor, zitiert von heise, haben mehrere Abteilungen des US-Justizministeriums Untersuchungen eingeleitet, die Nvidia, Supermicro und Megaspeed betreffen und sich um die Rolle von Alice Huang drehen. Es gebe bislang keine Anzeichen für eine Anklage gegen den Konzern oder gegen Jensen Huang. Parallel hat der republikanische Senator Tim Scott verlangt, dass Huang und Handelsminister Howard Lutnick vor dem Bankenausschuss des Senats aussagen.

Huangs letzte Stunden, Kress und die Belegschaft

Bloomberg schreibt, Huang sei beim Abschied „gebrochen und erschüttert“ gewesen. Das Wall Street Journal berichtet, er habe Kress im Sommer bei einem Treffen zu Nvidias geplanten Garantien für Rechenzentrumsbetreiber als „Reh im Scheinwerferlicht“ bezeichnet; beide Berichte stützen sich auf ungenannte Quellen. Laut WSJ hinterfragte Kress zudem kreditbasierte Deals, an denen Huangs Schwiegersohn beteiligt war, und stutzte die Zusage für OpenAIs Rechenzentrumsprojekt in Ohio von zunächst im Gespräch befindlichen 250 auf 105 Milliarden Dollar. Ein Teil der Belegschaft fordert unterdessen Huangs Rückkehr: Laut Wired, zitiert von t3n, sammelte ein interner Beitrag mehr als 1.600 Kommentare, viele davon zugunsten des Ex-Chefs. Das Wired-Essay von Lauren Goode sieht darin das Ende des „Gründermärchens“ und zitiert einen früheren Beschäftigten: Wer alles im Blick haben wolle, könne schwerlich Unwissenheit über den Verbleib von Chips behaupten.

Das Loch in der Startup-Finanzierung

Besonders konkret sind die Folgen für Venture Capital. Laut PitchBook, zitiert von TechCrunch, beteiligte sich Nvidia in diesem Jahr an 105 Finanzierungsrunden, oft als größter Geldgeber – von CoreWeave und Crusoe über Mistral AI und Lambda bis Black Forest Labs. Für den Kauf von Hugging Face hat Nvidia rund 13 Milliarden Dollar zugesagt; der Abschluss wird für 2027 erwartet. Investoren erwarten laut TechCrunch, dass Kress „viel konservativer“ agiert: kleinere Schecks, selektivere Neuinvestments, sinkende Bewertungen. „Wenn Nvidia in der Kapitaltabelle stand, fühlten sich alle sicher“, sagte Umesh Padval von Seligman Ventures. Die Aussagen sind Erwartungen einzelner Investoren, keine Nvidia-Ankündigung; The Information berichtet, Kress werde Veränderungen bei den Beteiligungen durchsetzen.

Der Blick aus Israel, wo Nvidia rund 6.000 Menschen beschäftigt, fällt differenzierter aus. Yanai Oron von Vertex Ventures Israel hält es für möglich, dass langsamere Entscheidungen bei Nvidia Wettbewerbern eine Chance eröffnen. Adi Levanon von Selah Ventures betont, ein Führungswechsel allein gewinne Herausforderern keine Kunden.

Einordnung

Die Lage bleibt zweigeteilt: Der Führungswechsel ist Fakt, der Skandal ein Geflecht aus Eingeständnis, Berichten und Dementis. Für Praktiker zählt vor allem, dass Nvidias Finanzierungs- und Garantiemodell – ein Kernstück des Rechenzentrumsbooms – unter neuer Führung offenbar überprüft wird. Wer als Startup oder Betreiber von Nvidia-Kapital oder -Garantien abhängt, sollte Alternativen und Fristen prüfen.

Politik · Chip-Exporte

Forensik an Modellgewichten: Chinas stärkste KI-Modelle tragen den Fingerabdruck exportbeschränkter Blackwell-Chips

Hintergrund & Analyse

Die führenden offenen Sprachmodelle aus China sind laut einer neuen Untersuchung auf Nvidia-Chips entstanden, die die US-Regierung nicht nach China liefern lässt. TechCrunch (Autor: Tim Fernholz) greift am Freitag eine am 12. November veröffentlichte Analyse von Will DePue auf, einem früheren OpenAI-Forscher, der die gemeinnützige Gruppe Unemployment Labs leitet. Die Vorwürfe stammen damit aus einer einzelnen, bislang nicht unabhängig begutachteten Studie; die beteiligten Konzerne haben sich nach den uns vorliegenden Berichten (Crypto Briefing, Stand 12. November) noch nicht geäußert.

Was die Analyse gefunden hat

DePue wertet ausschließlich öffentlich freigegebene Modellgewichte aus – keine Leaks, keine Insiderquellen. Sein Ansatz: Vor dem Training werden die Gewichte mit Zufallszahlen initialisiert. In PyTorch verteilt die Zufallsfunktion (Philox) diese Arbeit auf Tausende parallele GPU-Threads; wie die Werte im Gewichtsfeld landen, hängt von der Anzahl der Recheneinheiten (Streaming Multiprocessors) des Chips ab. Hopper-Chips wie H100, H200 und H800 haben 132, Blackwell B200/B300 haben 148, GB200/GB300 haben 152. Weil Teile der Gewichte im Training unverändert bleiben oder die Startwerte schwach nachwirken, lässt sich rückwärts rechnen, auf welcher Hardware die Startgewichte erzeugt wurden.

Nach dem Bericht passen sechs Modelle vierer Labore zu Blackwell: DeepSeek-V4-Flash und -V4-Pro (April 2026), Kimi K3 und K3.1-Pro von Moonshot AI (Juli bzw. November 2026), MiniMax-M3 (Juni 2026) und Ling-3.1-flash von Ant Group (Oktober 2026). Frühere Modelle derselben Labore lesen sich dagegen als Hopper-trainiert. Auf echter Hardware reproduzierte eine B300 die erhaltenen Startwerte von DeepSeek-V4-Flash zum Teil Bit für Bit, eine gemietete GB200 alle 13 geprüften Zeilen von Kimi K3; ein um eins verschobener Seed zerstörte jeden Treffer. Die statistische Signifikanz liegt je Modell zwischen 49 und 1.385 Sigma, die Schwelle für Zufallstreffer bei rund 8. Für DeepSeek-V4-Flash nennt die Studie die Evidenz „conclusive“, für die übrigen fünf „strong“.

Die Größenordnung: Aus Modellgröße und Trainingsdaten schätzt DePue für Kimi K3 etwa 4.500 und für DeepSeek-V4-Pro etwa 3.000 Blackwell-GPUs über zwei bis drei Monate, insgesamt rund 12.000 für die fünf Läufe. Zu rund 70.000 Dollar je GPU wären das für die größten Cluster 200 bis 300 Millionen Dollar.

Was die Studie nicht belegt

Die Grenzen benennen sowohl DePue als auch TechCrunch deutlich. Die Methode identifiziert die Hardware, die die Startgewichte erzeugt hat – nicht jeden Chip, der später trainiert hat. Sie sagt nichts über Standort, Eigentümer oder Beschaffungsweg. Blackwell-Systeme lassen sich auch in Rechenzentren außerhalb Chinas mieten; DePue schreibt, die Befunde seien „not a finding that any law was broken“. Ob DePues Ergebnis von anderen Fachleuten bestätigt wird, ist offen: Crypto Briefing zufolge sagt er, leitende Forscher bei OpenAI und Anthropic hätten es unabhängig geprüft – das ist seine Aussage, der Bericht nennt keine Gutachter. Code und Daten stehen laut Studie öffentlich auf GitHub bereit.

Einordnung: Exportkontrolle und Schlupflöcher

Blackwell-Chips dürfen nicht an China oder chinesische Unternehmen geliefert werden. Die Trump-Regierung erlaubt den schwächeren H200, sofern die Lieferung über einen Umweg läuft, der den USA einen Zoll von 25 Prozent einbringt. TechCrunch verweist darauf, dass das Weiße Haus (Michael Kratsios) schon früher in diesem Jahr unter Berufung auf Geheimdienstquellen erklärt hatte, Moonshot habe gesperrte Nvidia-Chips genutzt. Epoch AI schätzt, dass 2024 und 2025 rund zwei Millionen fortgeschrittene Chips über Verschleierungsrouten nach China gelangten; allein nach Malaysia seien 275.000 Nvidia-Beschleuniger importiert worden. Das zeigt das zentrale Schlupfloch: Chinesische Firmen mieten Rechenleistung in Drittländern. Sam Bresnick vom Georgetown CSET argumentiert, es sei widersinnig, Zugriff in China zu verbieten, aber in Malaysia zu dulden. Falken fordern deshalb Kontrollen, die nicht nur Besitz und Standort, sondern die Nutzung der Chips betreffen.

Folgen für Nvidia und Washington

Der Befund trifft Nvidia in der ohnehin akuten Krise um Jensen Huang, über die wir in unserer Ausgabe vom 13. November berichtet haben. Hier genügt die Verbindung: Megaspeed, die Firma von Alice Huang, steht im Zentrum von Schmuggelvorwürfen und wird von US-amerikanischen und singapurischen Behörden untersucht; Bloomberg meldet zudem, ein mit ihr verbundenes Unternehmen sei an der Lieferung gesperrter Chips an ein Rechenzentrum in Shanghai beteiligt gewesen. Nvidia und Huang hatten die Rechenzentren von Megaspeed nach TechCrunch öffentlich als legitim bezeichnet. Für Nvidia entsteht daraus ein mögliches Haftungsrisiko, falls Ermittler Schmuggel und Kenntnis im Management nachweisen. Heute haben US-Unternehmen nur begrenzte Pflichten, die Verwendung kontrollierter Güter durch Kunden zu verfolgen; über Chip-Tracking hatten wir am 13. November berichtet.

Politisch gerät auch das Handelsministerium unter Howard Lutnick unter Druck: Laut New York Times fanden seine Ermittler verdächtige Käufer nicht und standen Nvidia zu nah; Lutnick könnte laut Berichten sein Amt verlieren.

Was Unternehmen daraus ziehen sollten

Für europäische Unternehmen, die chinesische Open-Weight-Modelle wie DeepSeek V4 oder Kimi K3 einsetzen, ist die Lizenzlage der Modelle selbst unverändert; ein Rechtsverstoß ist nicht belegt. Wer solche Modelle in Produkte oder Lieferketten einbindet, sollte jedoch Compliance und Reputationsrisiken neu bewerten und prüfen, wie Rechenzentrumsanbieter in Drittländern ihre Kunden prüfen. Wer GPUs vermietet, muss mit schärferen Know-your-customer-Pflichten rechnen.

KI-Agenten · Zahlungsverkehr

ChatGPT Wallet: OpenAIs „Dots“ dürfen einkaufen – mit Einmal-Token und Fingerabdruck

Hintergrund & Analyse

OpenAI hat am Freitag mit ChatGPT Wallet eine Zahlungsfunktion für seine Agenten, die „Dots“, vorgestellt. Laut OpenAI-Ankündigung, TechCrunch und CNBC sollen die Agenten künftig nicht mehr nur Produkte recherchieren, sondern den Kauf auch abschließen. Das ist der zweite Anlauf des Konzerns im Handel: Den 2025 eingeführten „Instant Checkout“ gab OpenAI laut CNBC rasch auf und stellte im März 2026 stattdessen eine überarbeitete Produktsuche vor. Die Dots hatte OpenAI Ende September auf seiner Entwicklerkonferenz eingeführt; Hintergründe zur Debatte um Vertrauen und Datenschutz bei Agenten lesen Sie in unserer Ausgabe vom 11. Oktober.

So läuft ein Kauf ab

Nutzer hinterlegen ihre Karte einmalig in der Wallet und bitten dann ihren Dot, etwas zu besorgen. Vor dem Abschluss zeigt das System laut OpenAI die Artikel, den Gesamtbetrag und die gewählte Karte an. Der Nutzer bestätigt mit einer Sicherheitsabfrage wie Face ID oder Fingerabdruck; die Freigabe erzeugt zugleich einen Nachweis darüber, was genehmigt wurde. Ohne diese Bestätigung kann der Agent keinen Wallet-Kauf abschließen.

Technisch zentral ist ein Zahlungs-Token: Das Zahlungsnetzwerk stellt dem Dot nach CNBC-Angaben einen Ersatz mit eigener Kartennummer, Sicherheitscode und Ablaufdatum aus, der auf die jeweilige Transaktion begrenzt ist. Weder der Agent noch der Händler erhalten die echten Kartendaten. Der Händler bekommt vom Dot nur, was er zur Erfüllung braucht, etwa Lieferadresse und Kontaktdaten. Preis, Lieferung, Retouren und Kundenservice bleiben beim Händler.

Wer mitmacht – und wer nicht

Als Partner nennt OpenAI American Express, Mastercard und Visa. Zum Start können nur ausgewählte US-Abonnenten von ChatGPT Pro ab 18 Jahren teilnehmen, die eine in den USA ausgegebene Karte dieser Netzwerke besitzen. Wie viele Nutzer zur ersten Gruppe gehören und wann die Funktion breiter verfügbar ist, hat OpenAI laut tbreak nicht mitgeteilt. Amex-Manager Luke Gebb sagte CNBC, ein kontrollierter Start sei „der richtige Ansatz“; OpenAI könne später „die Lautstärke aufdrehen“. Für Händler veröffentlichte OpenAI ein „Commerce Partner Playbook“ und arbeitet nach Angaben von TestingCatalog und tbreak mit den Betrugsabwehr-Anbietern Forter, Riskified, Sardine und Signifyd sowie den Zahlungsdienstleistern Adyen, Checkout.com und Stripe zusammen. Denn bestehende Risikosysteme könnten legitime Agentenkäufe als Betrug werten und ablehnen.

Schutzmechanismen und Datenschutz

Kunden behalten laut OpenAI die Kartenvorteile, etwa Bonuspunkte, und den Schutz bei Streitfällen, zum Beispiel bei defekter Ware. Banken und Netzwerke prüfen die Transaktionen weiter wie bisher. Ausgabenlimits, Kategorien oder Zeitfenster, mit denen Nutzer Käufe vorab freigeben und dem Agenten mehr Autonomie geben könnten, stehen auf der Roadmap, sind aber nicht Teil des Starts. OpenAI nimmt zunächst keine Provision. Offen bleibt, welche Daten OpenAI selbst über Einkäufe speichert; die Ankündigung beschreibt vor allem, was Agent und Händler nicht sehen – die Frage, was die Plattform sieht, beantworten die uns vorliegenden Berichte nicht.

Wettbewerb und Gegenwind

Mit dem Schritt reagiert OpenAI auf den Boom persönlicher Agenten. Laut TechCrunch bietet auch der Agent Instinct Käufe an, und Metas Muse (über 10 Millionen Nutzer) verzeichne Einkaufen als Top-Aktivität. Zugleich sind die Zahlen gedämpft: DoorDash und Uber melden bisher nur wenige Bestellungen durch Agenten. Amazon, laut TechCrunch der größte Händler, der Agenten ausschließt, will Kunden zu seinem eigenen Assistenten Alexa lenken; United Airlines kündigte an, Agenten beim Ticketkauf zu blockieren. Die Sperrwelle hatten wir in unserer Ausgabe vom 18. Oktober beschrieben. Auf der anderen Seite erlaubt Walmart laut tbreak (unter Berufung auf The Next Web) Agenten den Einkauf mit eigenen Ausgabenlimits.

Einordnung und Risiken

Bestätigt ist das Konstruktionsprinzip: Das Zahlungsnetzwerk bleibt Vertrauensanker, der Mensch bleibt per Biometrie im Loop. Das schützt vor dem naheliegendsten Risiko, einem Agenten, der Kartendaten ausplaudert oder eigenmächtig Geld ausgibt. Es löst aber nicht alles: Ein Agent kann falsche Produkte wählen, Betrüger könnten ihn mit manipulierten Seiten täuschen – die Bestätigungsmaske ist hier die letzte Kontrollinstanz – und Händler könnten die Käufe schlicht blockieren. Der Komfortgewinn ist zudem begrenzt, solange jeder Kauf einzeln bestätigt werden muss. [INFERENCE] Der eigentliche Praxistest beginnt daher erst mit den angekündigten Limits, die Teilautonomie erlauben, und mit der Frage, wie viele Händler ihre Kassen für Agenten öffnen.

Hinweis zur Quellenlage: Die Ankündigung von OpenAI selbst war uns nicht abrufbar (HTTP 403); die Beschreibung stützt sich auf TechCrunch, CNBC, TestingCatalog und tbreak, die übereinstimmend berichten. Die Angaben zu Walmart stammen aus Sekundärberichten und sind von uns nicht unabhängig geprüft.

Unternehmen · Agenten-Plattformen

LangChain sammelt 300 Millionen Dollar bei drei Milliarden Bewertung ein – Wette auf die neutrale Schicht für Unternehmensagenten

Hintergrund & Analyse

LangChain hat nach eigenen Angaben eine Series C über 300 Millionen Dollar bei einer Bewertung von drei Milliarden Dollar abgeschlossen. Das Unternehmen hat die Runde am Freitag per Blogeintrag von Mitgründer und CEO Harrison Chase und einer Pressemitteilung verkündet; TechCrunch berichtete am selben Tag. Angeführt wird die Finanzierung vom Bestandsinvestor CapitalG, dem Wachstumsfonds von Alphabet. Neu dabei sind laut LangChain der Singapurer Staatsfonds GIC und DFJ Growth, die Bestandsinvestoren IVP und Sapphire Ventures beteiligten sich erneut. Außerdem steigen Salesforce Ventures, Insight Venture Partners, QuantumLight und MongoDB Ventures ein; Sequoia, Amplify und Benchmark haben ihr Engagement aufgestockt.

Zum Vergleich: Im Oktober 2025 hatte LangChain laut TechCrunch 125 Millionen Dollar unter Führung von IVP bei einer Bewertung von 1,25 Milliarden Dollar eingesammelt. Die Bewertung hat sich somit in rund einem Jahr mehr als verdoppelt, wie auch das Wall Street Journal in der Überschrift seiner Exklusivmeldung festhält. Zu Umsatz, Wachstumsraten oder Profitabilität macht LangChain in der Ankündigung keine Angaben. Die Bewertung lässt sich daher nicht an einer Kennzahl messen; belastbar sind bislang nur Nutzungs- und Kundenzahlen aus Unternehmensmitteilungen.

Vom Open-Source-Baukasten zur Betriebsplattform

LangChain entstand Ende 2022 als Open-Source-Projekt von Chase und handelte damals jene Aufgaben ab, mit denen frühe Sprachmodelle haderten: Websuche, API-Aufrufe, Datenbankzugriffe. TechCrunch schreibt, dass die großen KI-Labore diese Fähigkeiten inzwischen selbst in ihre Werkzeugkästen („Harnesses“) einbauen und LangChain seinen Fokus deshalb auf die Verwaltung von Agenten verlagert habe. Kommerzielles Produkt ist LangSmith, nach Firmenangaben eine framework-unabhängige Plattform, um Agenten zu betreiben, zu verbessern und zu steuern. Sie gliedert sich in drei Säulen:

Agent Runtime umfasst die Open-Source-Bausteine Deep Agents, LangGraph und LangChain sowie Agent Server und Sandboxes für den Betrieb in der Cloud oder in der eigenen Umgebung, dazu vollständig verwaltete Angebote (Managed Agents, Fleet). Agent Improvement bündelt Observability, Evaluierung, Fine-Tuning auf Basis von Agenten-Traces und „LangSmith Engine“, einen Agenten, der Fehler in der Produktion sucht, Korrekturen für Code und Prompts schreibt und auf Regressionen achtet. Agent Governance schließlich meint zentrale Gateways für Modelle und Werkzeuge, mit denen sich Modellbudgets, Ausweichmodelle, Datenschutz und Zugriffsrechte steuern lassen. Am 20. November will LangChain weitere Funktionen vorstellen.

Zahlen: Kunden und Downloads – vom Unternehmen selbst

Mehr als 7.000 Organisationen nutzen LangSmith nach LangChain-Angaben, genannt werden Start-ups wie Harvey, Rippling und Listen Labs sowie Konzerne wie Nvidia, Toyota und Salesforce. Clay überwache damit Hunderte Millionen Agentenläufe pro Monat; Workday habe die Zeit für die Bereitstellung eines neuen Agenten von fünf Monaten auf unter einen Tag gesenkt. CapitalG ergänzt in seinem Investment-Beitrag, die Open-Source-Projekte kämen auf mehr als 350 Millionen Downloads im Monat, nach rund 90 Millionen für LangChain und LangGraph zur Series B, und insgesamt auf über eine Milliarde Downloads. Alle diese Zahlen stammen von LangChain oder seinem Lead-Investor und sind unabhängig nicht überprüft. Downloads sagen zudem wenig über zahlende Nutzer aus, und „Kunde“ kann vom Einzelentwickler bis zum Konzernvertrag vieles bedeuten.

Wettbewerb: Labore, Clouds und Neulinge

LangChains Positionierung lautet „Own your intelligence“: Unternehmen sollen Modell, Daten und Infrastruktur selbst wählen und kontrollieren. Das richtet sich gegen die Bindung an einzelne Anbieter. Laut TechCrunch betonen die Firma, LangSmith binde Nutzer an kein Modell, keine Cloud und kein Ökosystem – anders als die großen Clouds oder Frontier-Labore. CapitalG räumt ein, dass Modellanbieter und Hyperscaler eigene Agentenwerkzeuge ausliefern, „much of it very good“; Unternehmen mit Hunderten Agenten über mehrere Anbieter hinweg brauchten aber eine neutrale Schicht. Das ist die Investorenthese, kein Beleg. TechCrunch weist zugleich darauf hin, dass viele andere Start-ups ähnliche Versprechen machen und ebenfalls gut laufen; als Beispiel dient der Neuling Mintive, der Identität für Agenten verwaltet. LangChains Vorteil sei der Vorsprung und die Verbreitung.

Einordnung für Unternehmen

Für IT-Entscheider zeigt die Runde vor allem, dass sich die Wertschöpfung von der Entwicklung einzelner Agenten zum Betrieb verschiebt: Beobachtbarkeit, Tests, Kostenkontrolle und Zugriffsrechte werden zur eigenen Disziplin. Wer mehrere Modelle und Clouds nutzt, hat gute Gründe, Orchestrierung und Auswertung nicht beim Modellanbieter zu belassen. Zugleich sollten Käufer nüchtern prüfen: Welche Bestandteile sind Open Source, welche nur im kommerziellen LangSmith verfügbar? Was kostet der Betrieb im eigenen Cloud-Konto (laut Anbieter auch bei AWS, Azure und Google Cloud möglich) gegenüber der Hosted-Variante? Und wie portabel sind Traces und Evaluierungen, falls man wechseln will? Ein Hype-Zyklus allein trägt eine Bewertung von drei Milliarden Dollar nicht; ob der Umsatz sie rechtfertigt, ist von außen nicht beurteilbar.

Sicherheit · Vibe Coding

Über 35.000 mit Grok gebaute Web-Apps standen offen – darunter Kundendaten, Patientenakten und Klartextpasswörter

Hintergrund & Analyse

Mehr als 35.000 Web-Apps, die Nutzer im „Build“-Modus von Grok per Chatbeschreibung haben schreiben lassen, waren für jedermann ohne Anmeldung abrufbar. Das ergibt eine Untersuchung des israelisch-amerikanischen Sicherheitsunternehmens Claroc, die am 10. November 2026 erschien und in den Folgetagen unter anderem von Ars Technica, heise online und – am 13. November – von Golem.de aufgegriffen wurde. Wir datieren das Ereignis daher auf die Veröffentlichung der Studie, nicht auf den Tag der deutschsprachigen Berichte. Anbieter von Grok ist SpaceXSI, der Zusammenschluss von SpaceX und xAI.

Die Zahlen stammen aus der Studie selbst und sind in den Berichten übereinstimmend wiedergegeben: Claroc ermittelte über DNS-Daten 43.601 Namen unter der Domain grok.me, auf der Grok veröffentlichte Apps ausliefert. Von 43.551 abgefragten Adressen waren 37.571 noch online, 35.578 davon (94,7 Prozent) öffneten ohne Anmeldung. Nur 1.993 antworteten mit dem Fehler HTTP 401, wie ihn eine auf „Nur du“ oder „Eingeladene Nutzer“ gestellte App liefert. Die meisten offenen Apps waren harmlos – Spiele, Landingpages, Rechner. Laut Claroc enthielt etwa jede zehnte sensible Inhalte; eine Stichprobenhochrechnung ergibt 650 bis 800 Apps mit privaten Daten. Diese Hochrechnung ist eine Schätzung der Forscher, keine vollständige Prüfung.

Was offenlag

Zu den von Claroc beschriebenen Funden gehören die Dienstpläne eines Krankenhausverbunds mit mehr als 3.500 Mitarbeitern, das Intensivbriefing für einen einzelnen Patienten mit Laborwerten und Beatmungsstatus, eine Fahrerliste eines Speditionsunternehmens mit mehr als tausend Personen sowie eine Zeiterfassung, in deren Skriptdatei 18 Konten samt Klartextpasswort standen, Administratoren eingeschlossen. Außerdem fanden die Forscher interne Daten von 30 identifizierbaren Organisationen, 26 mit über 1.000 Beschäftigten, sechs aus den Fortune 500. Ars Technica nennt weitere Beispiele, die auf Angaben von Claroc beruhen, etwa die Belegung eines Sprengstofflagers bei einem Rüstungskonzern. Die Studie nennt keine Betroffenen beim Namen; wir geben solche Zuordnungen nicht wieder.

Besonders heikel: 24 der offenen Apps stammten von SpaceXSI- und X-Mitarbeitern selbst, darunter ein als vertraulich markierter Einarbeitungsplan, eine Vertriebskarte mit 594 Kundenkonten und Werbeangebote von X, eines an eine US-Bundesbehörde.

Ursache: Standard und Link-Design

Laut Claroc kommen zwei Dinge zusammen. Erstens schlug die Oberfläche beim Veröffentlichen im von den Forschern genutzten Bezahlkonto „Jeder mit dem Link“ bereits vorausgewählt vor. Zweitens liegt der Zufallsanteil der Adresse (typischerweise vier Zufallswörter) links der Domain, also im Hostnamen. Jeder Aufruf löst eine DNS-Anfrage aus, und kommerzielle Passive-DNS-Dienste speichern solche Anfragen in durchsuchbaren Datenbanken. Ein Mustersuchlauf nach „*.grok.me“ liefert damit eine Liste aller Apps, deren Adresse jemals aufgerufen wurde. Bei Google Docs oder geteilten Chats von ChatGPT, Claude und Gemini steht das Geheimnis dagegen im Pfad, den DNS nie sieht. Ars Technica berichtet zudem, dass auch Lovable, Bolt und Replit jeder App einen eigenen Hostnamen geben; die Forscher fanden bei Grok aber „mit Abstand“ die meisten sensiblen Firmendaten. Vor wenigen Wochen hatte Meta ein Link-Sharing von Muse nach ähnlichen Funden ausgesetzt.

Hinzu kommen Mängel im generierten Code. In zwei eigenen Testapps ließ Grok die erste ohne Anmeldung zu, sodass Fremde Datensätze hinzufügen konnten. In der zweiten, einer Teamkundenliste, wurde jeder, der sich mit Google anmeldete, erst dem Team hinzugefügt und dann geprüft – die Prüfung fiel also immer positiv aus. Schreibzugriffe testete Claroc nach eigener Aussage ausschließlich an den eigenen Apps; ob die fremden offenen Apps veränderbar waren, ist unbelegt.

Reaktion von SpaceXSI

Claroc meldete die Lücke am 8. November und die übrigen SpaceXSI-Apps am 9. November. Eine Antwort blieb zunächst aus. Auf Anfrage von Ars Technica ließ ein Vertreter von Cursor, das SpaceXSI übernommen hat, erklären, Apps seien standardmäßig privat und nichts werde ohne Zutun des Erstellers öffentlich. Laut SpaceXSI sind Mitarbeiterkonten standardmäßig auf „Nur du“ gestellt, und das Veröffentlichen erfordere mehrere ausdrückliche Schritte. Claroc bestätigt die Schritte, hält aber dagegen, dass am Ende der Zugriff für jeden voreingestellt sei, und verweist darauf, dass die Betreiber der 35.578 Apps alle Schritte durchlaufen hätten. Wenige Stunden nach der Presseanfrage nahm SpaceXSI die 24 eigenen Apps vom Netz. Die Apps fremder Nutzer blieben zunächst offen; ob SpaceXSI deren Betreiber informiert oder den Standard ändert, ist nach dem Stand der Berichte unbeantwortet. Claroc benachrichtigt betroffene Organisationen nach eigener Angabe selbst.

Was Unternehmen jetzt tun sollten

Die Studie ist zugleich Werbung für Claroc-Produkte, was bei der Bewertung der Empfehlungen zu bedenken ist; die Hinweise sind aber ohne Produkt umsetzbar. Erstens: klären, welche KI-App-Builder Beschäftigte nutzen – sie brauchen weder Admin-Freigabe noch Firmenkonto. Zweitens: eigene Apps aufspüren, etwa über Passive-DNS-Suchen nach den Builder-Domains, und die Fundstellen im Inkognitofenster öffnen. Drittens: bei allem Internen den Zugriff auf „Nur du“ oder „Eingeladene Nutzer“ setzen; wer nicht eingeladen ist, muss einen Fehler sehen. Viertens: Anmeldung von außen testen – kommt ein fremdes Google-Konto hinein, fehlt eine Zugriffsliste. Fünftens: Skriptdateien nach Namen, Mail-Adressen und Passwörtern durchsuchen, denn deren Inhalt lädt jeder Browser mit, und herrenlose Apps abschalten. Wer Personen- oder Gesundheitsdaten betroffen sieht, muss zudem die Meldepflichten nach DSGVO prüfen.

Politik · KI in der Verwaltung

Chatbots überfluten das EU-Parlament: Halluzinierte Gesetze, 50 Prozent mehr Beschwerden

Hintergrund & Analyse

Die EU versteht sich als globale Regulierungsmacht für künstliche Intelligenz. Im eigenen Haus zeigt sich nun die Kehrseite: Wie heise online am 13. November 2026 berichtet, werden die Institutionen in Brüssel und Straßburg von automatisiert erzeugten Texten überrollt. Heise stützt sich dabei auf das Portal Rapporteur, dessen Originaltext wir nicht einsehen konnten. Die Kernaussagen lassen sich jedoch zum Teil durch Politico Europe und das Europäische Parlament belegen.

Was belegt ist. Parlamentspräsidentin Roberta Metsola warnte am 4. November bei einer Veranstaltung zum KI-Einsatz im Parlament, KI-gestützte Änderungsanträge könnten „fundamental nicht die konstruktive Debatte mit einem Kollegen“ ersetzen. Wo KI genutzt werde, „sollten die Menschen das wissen“. Generalsekretär Alessandro Chiocchetti erklärte laut Politico, Beamte warnten vor einer Welle KI-geschriebener Änderungsanträge, einige davon mit Verweisen auf nicht existierende Gesetze. Er nannte den Fall eines Abgeordneten, der sich von einer KI juristisch beraten ließ und eine falsche Antwort erhielt: „Unsere Juristen brauchten zwei Tage, um ChatGPT zu widerlegen.“

Die Zahlen. Belastbare Gesamtzahlen nennt keine der Quellen. Heise zitiert einen hochrangigen EU-Beamten gegenüber Rapporteur, wonach die Beschwerden bei der Europäischen Bürgerbeauftragten infolge von KI um 50 Prozent gestiegen seien; diese Angabe ist bislang nur berichtet und nicht unabhängig bestätigt. Der konservative schwedische Abgeordnete Jörgen Warborn verweist laut heise darauf, dass der Industrial Accelerator Act über 5000 Änderungsanträge erhalten habe. Ob und wie viele davon KI-generiert sind, bleibt offen. Chiocchetti selbst spricht laut Politico von „Tausenden“ Änderungsanträgen, die man mit KI sortieren wolle.

Die institutionelle Antwort. Die Verwaltung will ihre Leitlinien für den KI-Einsatz „sehr bald“ der Parlamentsspitze vorlegen; die bestehenden Regeln für Mitarbeitende stammen von 2024. Chiocchetti fasst sie in drei Punkten zusammen: offenlegen, wenn KI genutzt wird; keine sensiblen Inhalte in öffentliche Werkzeuge eingeben; alles prüfen, bevor es den Schreibtisch verlässt, denn „es ist Ihr Name, der darauf steht“. Parallel baut das Parlament ein eigenes KI-Werkzeug auf eigener Infrastruktur für sensible Arbeiten. Kommerzielle Modelle dürfen laut Politico weiter für weniger sensible Aufgaben dienen. Am Donnerstag, dem 12. November, verabschiedete das Plenum zudem mit 405 zu 133 Stimmen bei 60 Enthaltungen eine Entschließung zu den institutionellen Aspekten von KI. Sie fordert menschliche Aufsicht, schließt rein automatisierte politische Entscheidungen aus und schlägt eine haushaltsneutrale „KI-Beobachtungsstelle“ des Parlaments vor.

Individuelle Gegenmaßnahmen. Der irische Liberale Barry Andrews hat sich laut heise eine eigene Richtlinie gegeben, die KI bei Abstimmungen, Plenarreden, Pressemitteilungen und Anfragen an die Kommission ausschließt. Das Papier trägt selbst den Hinweis, mit KI-Unterstützung entstanden zu sein. Warborn hält dagegen: KI dürfe nicht allein zur Überlastung des Systems dienen, steigere aber die Produktivität.

Unbestätigtes. Ausschließlich berichtet sind weitere Details. Abgeordnete sollen KI teils nutzen, um mit minimalem Aufwand Aktivität vorzutäuschen und in internen Ranglisten besser dazustehen. Unter Beamten wachse die Vermutung, die Kommission beantworte Anfragen ihrerseits mit KI; ein Parlamentsassistent sieht darin die Gefahr einer weitgehend menschenfreien Kommunikation zwischen den Institutionen. Belege dafür nennt heise nicht.

Einordnung. Der Fall zeigt ein Asymmetrieproblem: Die Kosten, einen Text zu erzeugen, sinken gegen null, die Kosten, ihn zu prüfen, bleiben hoch. Juristische Dienste und Dolmetscher, die in 24 Amtssprachen arbeiten, fangen die Fehler am Ende der Kette ab. Interessant ist zudem, dass die Maßnahmen auf Transparenz und Verantwortlichkeit setzen, nicht auf Verbote, ähnlich wie der AI Act für KI-generierte Inhalte. Das Muster passt dazu, dass Gerichte im Rechtsverkehr Anwälte bereits für halluzinierte Zitate rügen.

Was Organisationen daraus lernen können. Wer Eingaben von Bürgern, Kunden oder Mitarbeitenden entgegennimmt, sollte mit mehr und formal glatter, inhaltlich schwächerer Post rechnen. Sinnvoll sind Kennzeichnungspflichten für KI-Hilfe, Pflicht zu Quellenangaben, die sich stichprobenartig prüfen lassen, und eine klare Zuständigkeit: Wer unterschreibt, haftet. Vorsicht ist auch bei der Gegenmaßnahme geboten. Wer die Flut mit eigener KI beantwortet, erzeugt womöglich genau den Kreislauf, vor dem Chiocchetti warnt: Delegation der Debatte an einen Chatbot.

Tools · Lokale Inferenz

llama.cpp erreicht Version 1.0: Semantic Versioning für die Basis der lokalen KI

Hintergrund & Analyse

Das Team hinter llama.cpp hat am Freitag Version 1.0.0 der Inferenz-Bibliothek libllama und der darunterliegenden Tensor-Bibliothek libggml veröffentlicht. Das geht aus dem Blogbeitrag „llama.cpp v1.0.0: A stronger foundation for the local AI ecosystem“ auf Hugging Face und den Release-Notes auf GitHub hervor. Autoren des Beitrags sind unter anderem Projektgründer Georgi Gerganov, Daniel Bevenius und Merve Noyan. Der Beitrag verweist auf rund dreieinhalb Jahre seit dem ersten Commit und darauf, dass „viele nachgelagerte Anwendungen“ bereits von der Arbeit abhängen.

Was 1.0 bedeutet: eine Zusage zur Schnittstelle

Der Kern der Ankündigung ist keine neue Funktion, sondern ein Versionierungsvertrag. Künftig spiegeln llama.cpp und ggml Inkompatibilitäten bei API und ABI über Hauptversionen wider. Die Regeln gelten laut Blog für alle ggml-org-Projekte: Ein MAJOR-Sprung steht für einen Bruch in der öffentlichen C-API unter ./include, ein MINOR-Sprung für abwärtskompatible Funktionen, Backend-Updates, neue Modellunterstützung oder API-Erweiterungen, ein PATCH für Fehlerbehebungen ohne API-Änderung. Die Maintainer schreiben, man werde „strenger“ darin sein, diese Grenzen für nachgelagerte Entwickler sichtbar zu machen. Das ist für ein Projekt, dessen Master-Branch bisher in schneller Folge fortlaufend nummerierte Builds („b12374“ ist der aktuelle Stand vom Samstagmorgen) ausgespielt hat, ein Einschnitt in der Kommunikation – ein Nachweis, dass die Schnittstelle in der Praxis stabil bleibt, kann erst die Zukunft liefern.

Auffällig ist, dass 1.0 zugleich aufräumt: Laut Release-Notes entfernt die Version die als veraltet markierte öffentliche API, darunter 35 Funktionen, llama_set_warmup sowie den Parameter defrag_thold. Die NextN-API für spekulatives Decoding wandert aus llama-ext.h in den Haupt-Header llama.h, und clip.h entfällt zugunsten von mtmd. Wer eigene Anwendungen gegen die Bibliothek baut, sollte vor dem Umstieg also den Abschnitt „API changes“ der Release-Notes prüfen; die Zusage gilt ab jetzt, nicht rückwirkend.

Neue Funktionen und gehärteter Server

Daneben enthält der Release ein Bündel an Neuerungen. Neu sind FP8-Key-Value-Caches (-ctk/-ctv f8_e4m3), ein Host-Speicher-Cache für Experten von Mixture-of-Experts-Modellen mit einstellbarem CPU-Anteil sowie das Laden externer PLE-Gewichte aus getrennten GGUF-Dateien. Als neue Architekturen nennen die Notes Kimi-K3.1-Pro, Ripple-65B-Preview und „xing4_0“, dazu das Sprachsynthese-Modell drama-3 und Bildverarbeitung für MageVL-Cowork und Kimi-K3.1. Der llama-server erhält einen OpenAI-kompatiblen Endpunkt /v1/audio/speech und eine überarbeitete Weboberfläche. Für Betreiber wichtig sind die Sicherheitskorrekturen: Die Notes nennen Fixes gegen SSRF, fehlerhafte CORS-Behandlung und DNS-Rebinding, ein Opt-in für nicht authentifizierte Tools sowie die Beschränkung des HF_TOKEN auf Hosts von huggingface.co. Ergänzend erwähnt der Blog mehr als 150 unterstützte Architekturvarianten.

Verteilung und Infrastruktur

Der Blog listet Distributionskanäle: Release-Artefakte für Linux, macOS, Windows, Android und iOS sowie Docker, Debian, Homebrew, conda-forge, MacPorts, Winget und ein XCFramework für Apple-Plattformen. Hinweise für Packager sammelt das Projekt in einer GitHub-Diskussion. Für die Qualitätssicherung nutzt das Team nach eigenen Angaben HF Buckets und HF Jobs von Hugging Face; Hardware-Unterstützung für selbst gehostete Test-Runner kommt von Nvidia, AMD, Qualcomm, Arm, IBM und Intel. Außerdem betont der Beitrag, man setze LLMs in der Entwicklung „durchdacht“ ein, behalte aber die Kontrolle über Architektur und Implementierungsdetails.

Die Rolle von Hugging Face

Der Blog spricht vom „llama.cpp team at Hugging Face“. Hintergrund: Gerganovs Firma ggml.ai hat sich im Februar 2026 Hugging Face angeschlossen; das Projekt blieb offen. Simon Willison zitiert aus der damaligen Ankündigung die Ziele einer „Single-Click“-Integration mit transformers und besserer Paketierung ggml-basierter Software. Der Release liest sich als erste größere Etappe auf diesem zweiten Ziel. Auch das im Blog beworbene Desktop-Programm „Llama“ (llama.app) für macOS und Windows stammt vom Team hinter llama.cpp und Hugging Face.

Einordnung

Für Unternehmen, die llama.cpp einbetten, ist die Versionierung vermutlich wichtiger als jede einzelne Funktion: Wer die Bibliothek in Produkte oder interne Plattformen einbaut, kann Abhängigkeiten nun auf eine Hauptversion festlegen und Brüche an der Versionsnummer erkennen. Das ist unsere Einschätzung; ob und wie lange das Projekt ältere Hauptversionen mit Patches versorgt, nennen weder Blog noch Release-Notes. Auch Betreiber des llama-server im Netzwerk sollten die Sicherheitskorrekturen einplanen. Verbreitung und Stabilität dürften die lokale Inferenz als Alternative zur Cloud stärken – Hugging Face und Maintainer argumentieren genau so, mit Privatsphäre als Treiber.

Reportage

Taxi oder Dienstwagen? Wann sich selbst betriebene KI-Modelle gegenüber der API wirklich rechnen – und was auf keiner Kalkulation steht

Weiterlesen →

Tool-Radar

Neue und trendende KI-Tools des Tages

ElevenAI Logo
Experimentelle Team-App von ElevenLabs, die Meeting-Mitschriften, Diktierfunktion und Agenten-Anbindung in einem Werkzeug vereint.
ElevenAI wurde laut TechCrunch auf dem „11/11 Summit“ in New York vorgestellt und ist noch in der Vorschau; der Zugang läuft über eine Early-Access-Anmeldung. Die App protokolliert Meetings und weist die Teilnehmer auf die Aufnahme hin, erlaubt Fragen über mehrere Gespräche hinweg und diktiert in jeder Anwendung in mehr als 90 Sprachen. Über ElevenAgent lassen sich Folgeaktionen wie ein E-Mail-Entwurf aus den Notizen auslösen. ElevenLabs, nach TechCrunch-Angaben mit 22 Milliarden Dollar bewertet, zielt damit auf Unternehmensteams statt auf Einzelnutzer.
Produktivität · November 2026
Yogurt Logo
Quelloffene (MIT) Meeting-Notiz-App von Frigade, die Gespräche lokal transkribiert und zusammenfasst – ohne Bot im Call und ohne Konto.
Yogurt läuft auf Mac, Windows und Linux und nutzt whisper.cpp für die Transkription sowie ein lokales Open-Weight-Modell (Gemma 4, gpt-oss oder Qwen3 über llama.cpp) für Zusammenfassungen und Antworten über mehrere Meetings hinweg. Ein lokaler MCP-Server lässt andere Assistenten die Notizen lesen, der Zugriff ist standardmäßig aus. Das Projekt wurde am 11. November als „Show HN“ als kostenlose Alternative zu Granola vorgestellt und kam am 12. November auf Product Hunt; das GitHub-Repository zählt inzwischen über 1.200 Sterne. Die Modelle sind je nach Rechner mehrere Gigabyte groß.
Produktivität · November 2026
Omnigraph Logo
Quelloffene (MIT) Graphdatenbank in Rust von Modern Relay, die Agenten ein gemeinsames, typisiertes Weltmodell mit Git-artigen Branches bietet.
Omnigraph kombiniert Graph-Traversierung, Vektorsuche und Volltextsuche in einer Abfrage und speichert Daten im offenen Lance-Format auf lokalem Speicher oder S3-kompatiblen Objektspeichern. Jeder Agent kann auf einem eigenen Branch arbeiten, Änderungen werden per Drei-Wege-Merge geprüft; Cedar-Richtlinien setzen Rechte serverseitig durch. Das Projekt startete am 12. November auf Product Hunt (Platz 3 des Tages), eine Cloud-Version ist in privater Vorschau. Installation per Skript oder Homebrew, dazu eine Desktop-App „Studio“ und ein Agent-Skill für die Einrichtung.
Dev-Tools · November 2026
Spacefast Logo
Hosting-Dienst von Automattic, bei dem KI-Agenten wie Claude, ChatGPT oder Cursor selbst gebaute Apps und Websites veröffentlichen, mit Datenbank und eigener Domain.
Automattic stellte Spacefast am 9. November als eigenständige Firma unter Gründer Batuhan İçöz vor; ein Soft-Launch hatte im September stattgefunden. Der Agent verbindet sich per MCP, API oder CLI (npx spacefast publish), jede Veröffentlichung erhält eine eigene dauerhafte Adresse samt Rollback. Freigaben laufen standardmäßig privat, per Passwort, Einladung oder Link; für sensible Aktionen wie DNS-Änderungen verlangt der Dienst eine Bestätigung. Abgerechnet wird laut Automattic die Infrastruktur, nicht KI-Guthaben; es gibt einen kostenlosen Privatplan.
Dev-Tools · November 2026
Nameshot Logo
Mac-Menüleisten-App, die jedem neuen Screenshot per Apple Intelligence auf dem Gerät einen sprechenden Dateinamen gibt.
Entwickelt vom unabhängigen Entwickler Ryan McLeod (Amsterdam), erschien Nameshot am 10. November im Mac App Store und kam am 12. November auf Product Hunt. Die App hat laut Hersteller keine Netzwerkberechtigung, braucht kein Konto und sendet keine Analysedaten; „Tidy Up“ benennt ganze Ordner alter Screenshots. Nameshot ist kostenlos mit siebentägiger Testphase, Pro kostet einmalig 4,99 Dollar zum Start, danach 9,99 Dollar. Voraussetzung sind ein Mac mit Apple Silicon und macOS 27.
Produktivität · November 2026
InkoAI Agent Logo
Kreativ-Assistent der Singapurer Plattform DomoAI, der aus einem Satz fertige Bild- und Video-Clips für Social Media erzeugt und dabei jeden Schritt zur Freigabe vorlegt.
DomoAI kündigte den InkoAI Agent am 13. November an; er ist laut Pressemitteilung ab sofort verfügbar. Der Agent schreibt Prompts, wählt Format und Länge und greift auf 15 Bild- und Videomodelle zu, darunter GPT Image 2.5, Nano Banana Pro, Seedance 2.5 und MiniMax H3. Per Klick starten „Skills“ wie Short Drama oder Anime Video, die Skript, Figuren und Einstellungen vorab zur Freigabe zeigen. DomoAI nennt mehr als 5 Millionen Nutzer; die Angaben stammen vom Hersteller und sind unabhängig nicht überprüft.
Kreativ · November 2026

Aus der Werkstatt

YouTube-Empfehlungen: Tutorials, Erklärungen und Werkzeuge

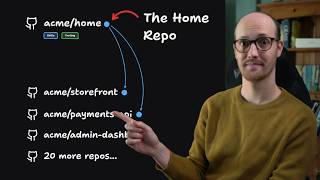
The Home Repo: The effortless multi-repo agent setup
Tutorial
Matt Pocock · 08:53
Matt Pocock stellt das „Home-Repo“-Muster vor: Ein zentrales Repository bündelt gemeinsame Agent-Skills, Steuerdateien und eigene Werkzeuge, damit Coding-Agenten über mehrere Repositories hinweg konsistent arbeiten. Das Video erklärt das Multi-Repo-Problem, führt durch sein eigenes Home-Repo und begründet, warum er statt eines Monorepos diesen Ansatz wählt. Zum Schluss geht es um ein persönliches Wiki und eigenes Tooling. Englisch, Upload am 12. November 2026.
Python Voice Agent Tutorial: Clone Your Voice & Talk to AI
Tutorial
Tech With Tim · 15:44
Tech With Tim baut in unter 100 Zeilen Python einen Sprach-Agenten, der mit der geklonten eigenen Stimme antwortet. Das Video zeigt zunächst die Architektur, dann das Klonen der Stimme, das Projekt-Setup und den Code Schritt für Schritt; der Quellcode steht zum Download bereit. Hinweis: Das Video wird von AssemblyAI gesponsert. Englisch, Upload am 13. November 2026.

Inferenz-Bilanz

Ressourcenverbrauch & API-Kosten dieser Ausgabe

Transparenzbericht · Anthropic Claude Sonnet 5.5 (via Oh My Pi)

Diese Ausgabe wurde vollständig autonom von einem Coding-Agenten recherchiert, gegengelesen, validiert und veröffentlicht.

  • Token-Verbrauch: 9.477.801 Tokens gesamt (9.369.707 Eingabe · 108.094 Ausgabe in 170 Arbeitsschritten)
  • API-Kosten (Anthropic): 3,90 $